Schema.org : comprendre les données structurées
Schema.org : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au proj…

Le référencement QuietCMS associe des réglages techniques à une organisation éditoriale cohérente. Cette rubrique présente les éléments utiles au SEO et à la compréhension des contenus par les outils IA : titres, URL, données structurées, exploration et maillage. Les guides ci-dessous approfondissent des mécanismes précis et leurs conditions d’utilisation. Le dossier placé après les extraits explique comment relier ces réglages aux intentions des lecteurs, construire des rubriques utiles et interpréter les signaux observés. Il distingue les moyens que le site maîtrise des décisions prises par les moteurs, sans promettre une indexation, un classement ou une citation automatique de chaque contenu publié.
Schema.org : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au proj…
Comprenez search console dans QuietCMS : fonctionnement, usages et limites. Un guide pour préparer l’intégration et vérifier les points importants du site.
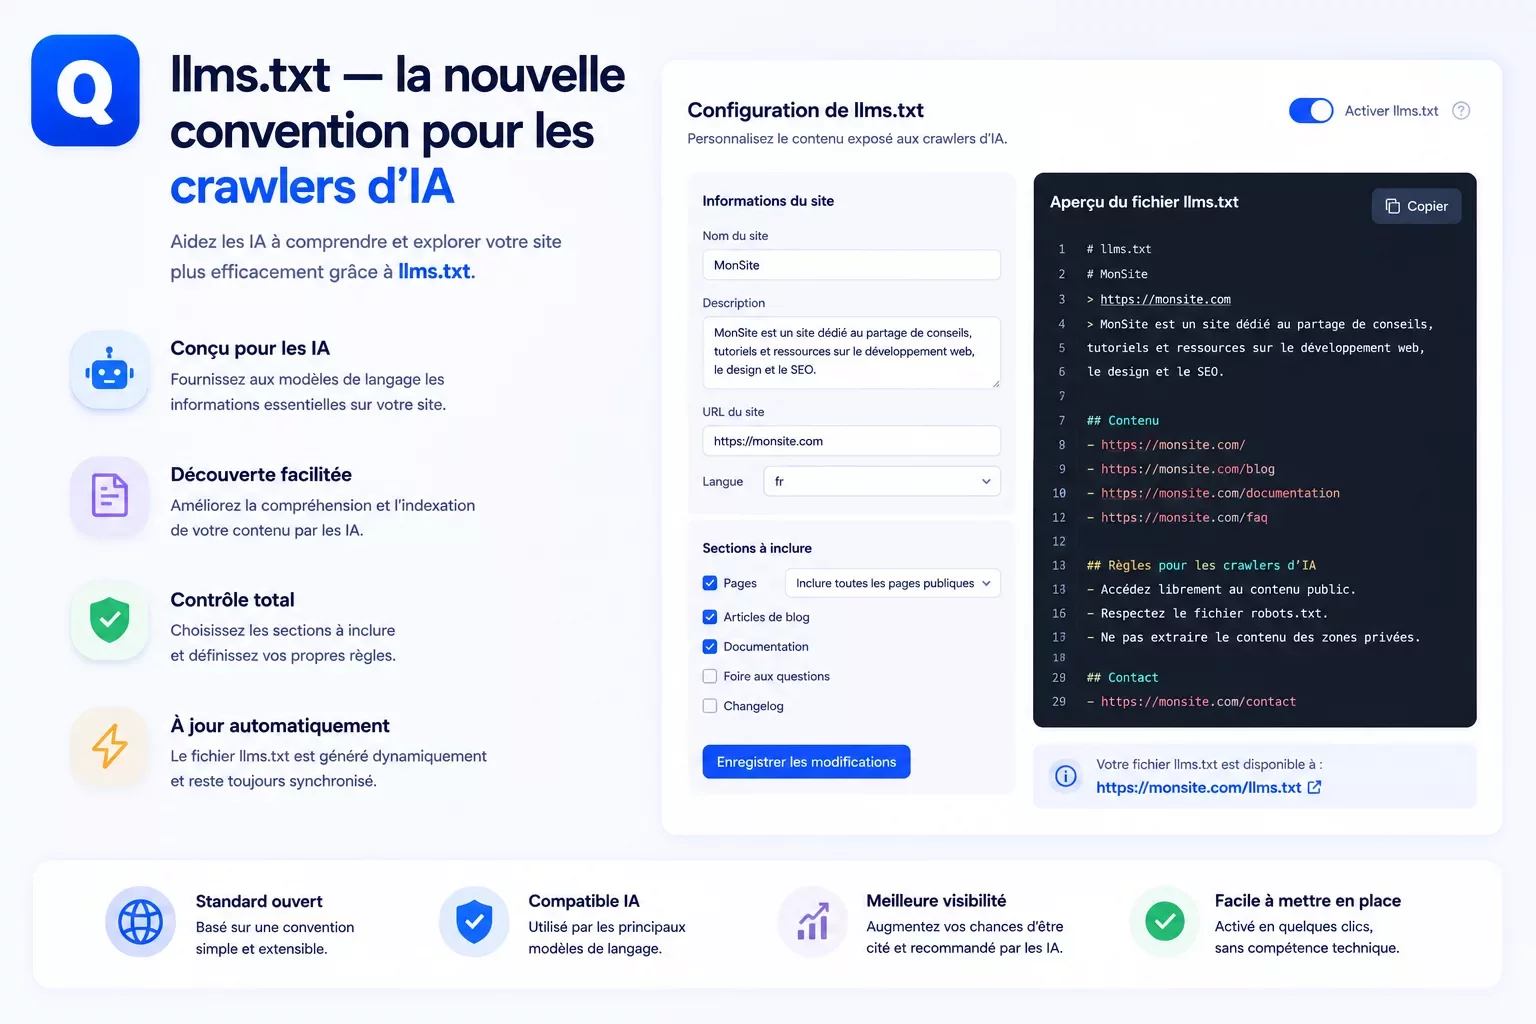
Llms.txt : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au projet.
Robots.txt : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au proj…
Meta robots : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au pro…
Comprenez url canonique dans QuietCMS : fonctionnement, usages et limites. Un guide pour préparer l’intégration et vérifier les points importants du site.
Sitemap XML : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et les vérifications utiles au pro…
QuietCMS génère automatiquement JSON-LD (Article, WebPage, BreadcrumbList) et Open Graph par page et article.
Découvrez llms.txt, la spécification émergente pour guider les crawlers IA (ChatGPT, Claude, Gemini) vers le contenu le plus pertinent de votre site.
Tout comprendre sur le protocole sitemap XML : balises loc, lastmod, priority, extensions image/video, et comment QuietCMS l'implémente nativement.
Un contenu ne peut être utile aux moteurs que s’il est accessible, identifiable et compréhensible dans le site qui l’héberge. Le référencement commence donc par des décisions techniques et éditoriales qui précèdent la première phrase d’un article. Il faut déterminer l’adresse de la ressource, son rôle dans l’arborescence, ses relations avec les autres pages et les informations qui permettront de la distinguer. QuietCMS rassemble plusieurs de ces réglages dans son administration. Cette présence facilite leur gestion, mais elle ne remplace pas la réflexion sur le besoin auquel le contenu répond. Une balise bien renseignée ne transforme pas un texte imprécis en réponse satisfaisante. De même, publier davantage de pages ne crée pas automatiquement une meilleure couverture du sujet. Le travail commence par un inventaire des intentions : découvrir, comprendre, comparer, mettre en œuvre ou résoudre un problème. Chaque page doit avoir une fonction identifiable et une place cohérente dans ce parcours. Le développeur prépare le socle qui permet de publier et d’explorer ces contenus ; le référenceur et le rédacteur précisent leur organisation et leur qualité. Cette collaboration évite de traiter les corrections SEO comme une couche ajoutée après la livraison. Elle permet aussi de mesurer plus justement les résultats, en distinguant ce qui relève de l’accessibilité technique, de la pertinence éditoriale et de la notoriété acquise par le site.
La balise title identifie la page dans son contexte technique et peut contribuer à sa présentation dans les résultats de recherche. Le H1 donne au lecteur le sujet principal du document. La meta description propose une synthèse éditoriale que le moteur reste libre de reprendre ou de remplacer. Ces trois éléments gagnent à être cohérents sans devenir une répétition mécanique. Dans QuietCMS, leur contrôle permet d’éviter qu’un titre générique de site prenne la place du sujet réel de chaque page. Un title décrit le contenu avec précision, tandis qu’un H1 peut formuler la question à laquelle le document répond. La description doit annoncer ce que le lecteur trouvera effectivement, pas une promesse de résultat que le texte ne peut pas tenir. Les limites de longueur sont des repères de rédaction plutôt que des garanties d’affichage identiques dans tous les contextes. Une expression importante doit apparaître naturellement, sans accumulation de variantes artificielles. Avant de modifier ces champs sur un ensemble de contenus, il faut vérifier les règles automatiques du thème et les réglages globaux. Un ajout systématique du nom du site peut modifier la longueur de tous les titres. Une page qui possède un réglage spécifique peut ne pas suivre la règle commune. Le contrôle final se fait sur le HTML réellement servi, puis sur la cohérence avec le texte visible. Il doit inclure les archives, les pages paginées et les contenus traduits lorsque le site en propose.
Une URL stable facilite les liens, le partage et le suivi d’une ressource. Sa construction doit refléter l’organisation du site sans enfermer le projet dans une profondeur inutile. Les fonctions de QuietCMS calculent les chemins selon les règles retenues pour les pages, les rubriques et les articles. Les utiliser limite les divergences entre navigation, archives et liens ajoutés dans les modèles. La balise canonique indique l’adresse de référence choisie pour un contenu ; elle ne doit pas être utilisée comme un correctif universel à une architecture confuse. Une redirection répond à une autre situation : une ancienne adresse doit conduire vers une destination nouvelle ou équivalente. Lorsqu’un slug change, la destination doit exister avant la mise en place de la redirection. Les chaînes successives se contrôlent afin de ne pas transformer un lien simple en parcours inutilement long. Les boucles se corrigent à leur origine. Il faut aussi distinguer les variantes techniques, les paramètres de navigation et les documents éditoriaux réellement différents. La pagination d’une archive mérite une décision explicite, cohérente avec le comportement du site et les recommandations applicables. Une migration se prépare avec un inventaire des anciennes adresses et des liens importants. Modifier uniquement le menu laisse souvent subsister des références dans les articles, les images ou des ressources externes. Une architecture propre repose sur des liens internes mis à jour et sur des redirections destinées aux visiteurs qui arrivent encore par les anciennes voies d’accès.
Un cocon sémantique organise des contenus autour de besoins proches, en donnant à chaque niveau un rôle distinct. La page pilier présente le sujet et aide à choisir une direction. La rubrique regroupe un ensemble cohérent de problèmes. Les articles traitent chacun une question précise avec suffisamment de profondeur. Le maillage doit aider à passer d’un niveau à l’autre sans transformer chaque paragraphe en catalogue de liens. Sur un site technique, une rubrique sur l’architecture peut conduire aux guides de stockage et de routage ; une rubrique sur la sécurité doit réunir les opérations de protection et leurs conditions d’application. Mélanger tous les sujets dans les mêmes blocs de recommandations affaiblit la lisibilité du parcours. Le lecteur doit comprendre pourquoi un guide lui est proposé à cet endroit. Les pages de liste peuvent accueillir une introduction courte avant les extraits, puis un texte de fond après ceux-ci. Ce texte explique le périmètre de la rubrique, les décisions à prendre et les erreurs fréquentes, sans répéter les articles. La longueur reste au service d’un contenu utile ; elle ne prouve pas à elle seule la qualité du cocon. Les pages paginées ne doivent pas reproduire inutilement le même bloc éditorial. Les liens de navigation et les extraits assurent alors la continuité vers les autres ressources. L’ensemble se vérifie par ses relations réelles, ses adresses et l’absence de pages isolées, pas seulement par un schéma préparé avant publication.
Le sitemap présente des URL que le site souhaite rendre faciles à découvrir. Il doit refléter les contenus publiés et leurs règles d’indexation. Une ressource en brouillon ou explicitement exclue ne doit pas y apparaître par simple oubli de filtrage. Dans un CMS, la difficulté n’est pas seulement de produire un fichier XML valide : il faut le maintenir cohérent avec les publications, les changements d’adresse et les suppressions. Les règles du serveur peuvent également intervenir si un fichier statique ancien prend la priorité sur le générateur du moteur. Le contrôle doit donc porter sur la réponse effectivement reçue à l’adresse publique du sitemap. Le fichier robots.txt et les balises robots répondent à des fonctions différentes. Une consigne d’exploration ne constitue pas un dispositif de confidentialité et ne protège pas des données sensibles. Les ressources privées doivent être inaccessibles par les moyens de sécurité appropriés. Les paramètres associés aux robots se gèrent avec attention lors d’un passage de préproduction à production. Une restriction utile pendant la préparation peut rester active après le lancement si personne ne la vérifie. La recette comprend les codes de réponse, les canoniques, les règles d’indexation et les URL listées. Elle se poursuit dans les outils des moteurs lorsque ces derniers sont disponibles pour le projet. L’objectif est de rendre le site techniquement cohérent, pas de prétendre forcer l’indexation ni de garantir le délai auquel un moteur traitera une modification.
Le GEO désigne ici le travail sur la compréhension et la visibilité des contenus dans des environnements de recherche ou de réponse utilisant des modèles génératifs. Cette évolution ne supprime pas les besoins fondamentaux : des ressources accessibles, des sujets bien définis, des formulations explicites et des informations fiables. Les outils capables de suivre l’exploration par des robots IA aident à observer une partie de cette activité. Une visite technique ne prouve toutefois ni la reprise d’un contenu ni sa citation dans une réponse donnée. Les journaux doivent donc être interprétés sans confondre exploration, indexation, entraînement et affichage d’une source. QuietCMS peut fournir des éléments de gestion ou d’observation ; le choix final d’un système externe reste hors de son contrôle. Les données structurées et les documents d’orientation décrivent le site selon leurs formats et leurs usages. Ils ne constituent pas un bouton de visibilité universelle. Un fichier llms.txt peut présenter des ressources, mais sa présence ne garantit pas que tous les agents le liront ou le suivront. Le travail éditorial reste déterminant : préciser les entités, nommer les responsables, dater les informations quand c’est utile et distinguer un fait d’un exemple. Les promesses commerciales doivent rester proportionnées à ce qui peut être démontré. Une stratégie sérieuse sépare les signaux observables des hypothèses et fait évoluer ses contrôles lorsque les interfaces et les comportements des outils changent.
Les données structurées décrivent certains éléments du contenu dans un format lisible par des machines. Elles doivent correspondre à la page visible et utiliser un type adapté à la ressource. Un article, une organisation ou un fil d’Ariane ne portent pas les mêmes informations. Ajouter des propriétés sans rapport avec le contenu ne rend pas le document plus crédible. Le développeur doit vérifier les champs disponibles, leur exactitude et leur stabilité après modification du thème. QuietCMS dispose de fonctions pour produire ces éléments et les relier aux réglages éditoriaux. La sortie HTML reste le point de contrôle final, car un champ absent ou une condition de rendu peut modifier ce qui est réellement publié. Les informations de partage social obéissent à une logique voisine : titre, description et image doivent décrire correctement la ressource partagée. Une image absente, une adresse relative mal résolue ou un texte générique repris partout peut dégrader la présentation d’un lien. Les textes alternatifs répondent pour leur part à un besoin d’accessibilité et de compréhension de l’image dans la page. Ils ne servent pas à accumuler des mots-clés. Pour une capture d’administration, décrire l’écran et sa fonction est plus utile que répéter le nom du CMS plusieurs fois. Le suivi des métadonnées de médias permet de conserver cette information lors des réutilisations, à condition de respecter les chemins et les conventions du projet.
Une correction technique se valide d’abord par son effet attendu : une adresse répond correctement, une redirection mène à la bonne page, un formulaire conserve son fonctionnement ou une image charge avec des dimensions réservées. Les effets sur la visibilité se suivent ensuite dans un contexte plus large. Une variation de trafic peut coïncider avec une modification sans être causée uniquement par elle. La saisonnalité, les changements de contenu, la concurrence et l’évolution des moteurs participent au résultat. Il faut donc garder un historique des interventions et choisir des indicateurs adaptés à la question posée. Pour un problème d’exploration, les journaux et les réponses serveur sont plus directement utiles qu’un classement pris isolément. Pour une refonte éditoriale, la cohérence des pages, leurs impressions et les parcours des visiteurs donnent des informations complémentaires. Les tests de performance doivent préciser la page, le type d’appareil et les conditions de mesure. Un score isolé ne représente pas tout le site. Les rapports servent à décider d’une action concrète, puis à vérifier qu’elle n’a pas introduit une régression ailleurs. Ce travail se poursuit après la mise en ligne : nouvelles publications, modifications de catégories et évolutions du thème peuvent changer l’équilibre précédent. Un bon socle rend ces ajustements plus faciles à réaliser et à comprendre, sans se substituer au jugement de l’équipe qui pilote le référencement.
Un exemple pédagogique peut prendre une page consacrée à l’installation du CMS. Son intention principale est d’aider à démarrer un projet, et non de présenter toutes les fonctions du logiciel. Son titre, son introduction et ses étapes doivent refléter cette priorité. Les prérequis précisent les conditions nécessaires ; les explications signalent les décisions propres au serveur ; la fin du guide indique les contrôles permettant de vérifier le résultat.