La bibliothèque de classes core/ de QuietCMS
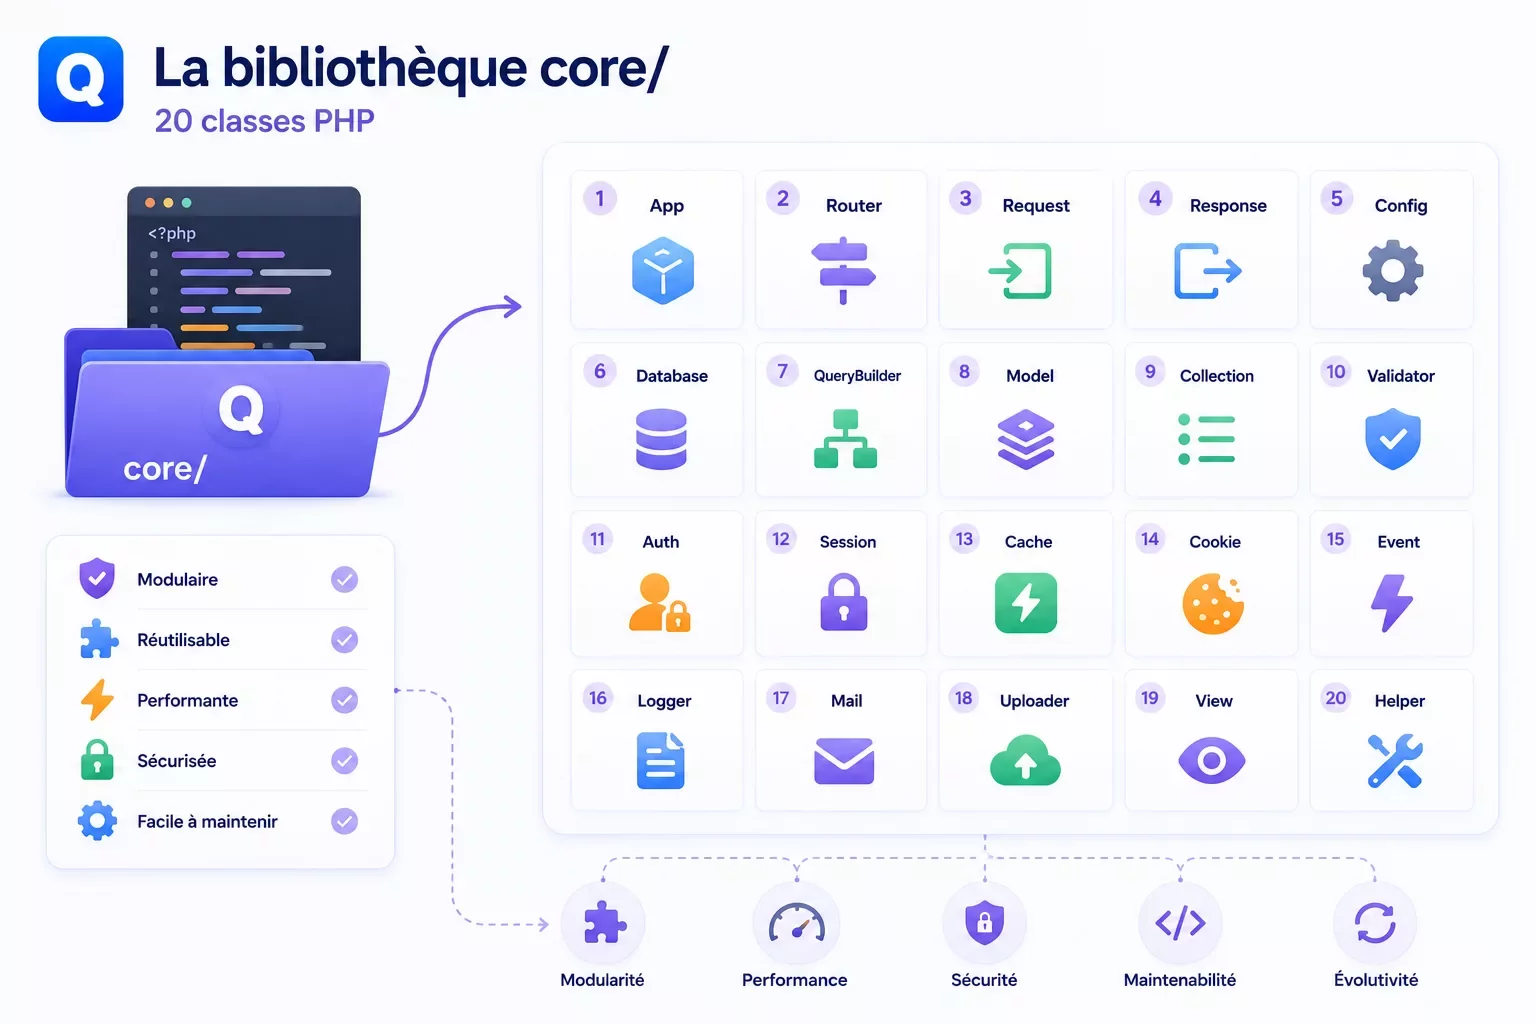
Tour d'horizon des 20 classes PHP de la bibliothèque core/ de QuietCMS et leurs responsabilités.
L’architecture QuietCMS repose sur PHP et des fichiers JSON, avec une séparation entre le moteur, les contenus et les thèmes. Cette rubrique donne aux développeurs les repères nécessaires pour comprendre le routage, le stockage, le cache et les conditions de déploiement. Les guides ci-dessous abordent chacun un mécanisme précis afin de faciliter les diagnostics et les évolutions du projet. Le dossier placé après les extraits explique comment relier ces composants sans confondre leurs responsabilités. Il aide à préparer une mise à jour, une reprise ou une migration en conservant les données, les adresses et les particularités utiles du site.
Tour d'horizon des 20 classes PHP de la bibliothèque core/ de QuietCMS et leurs responsabilités.
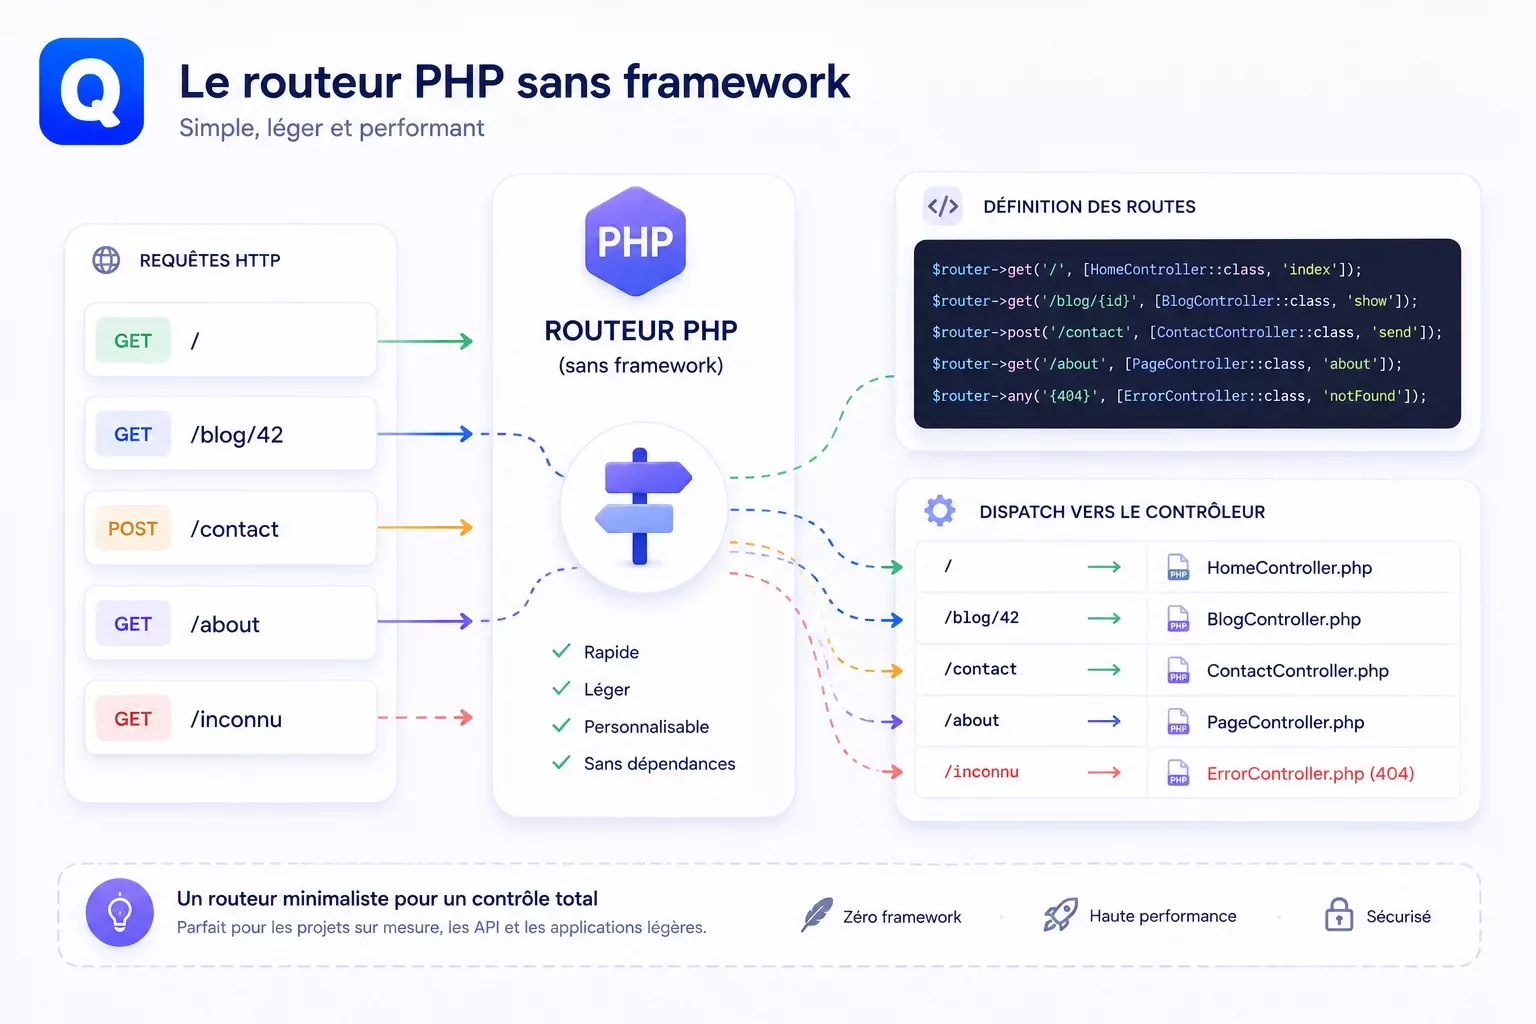
Comment QuietCMS implémente un routeur PHP léger sans framework pour gérer les URLs propres.
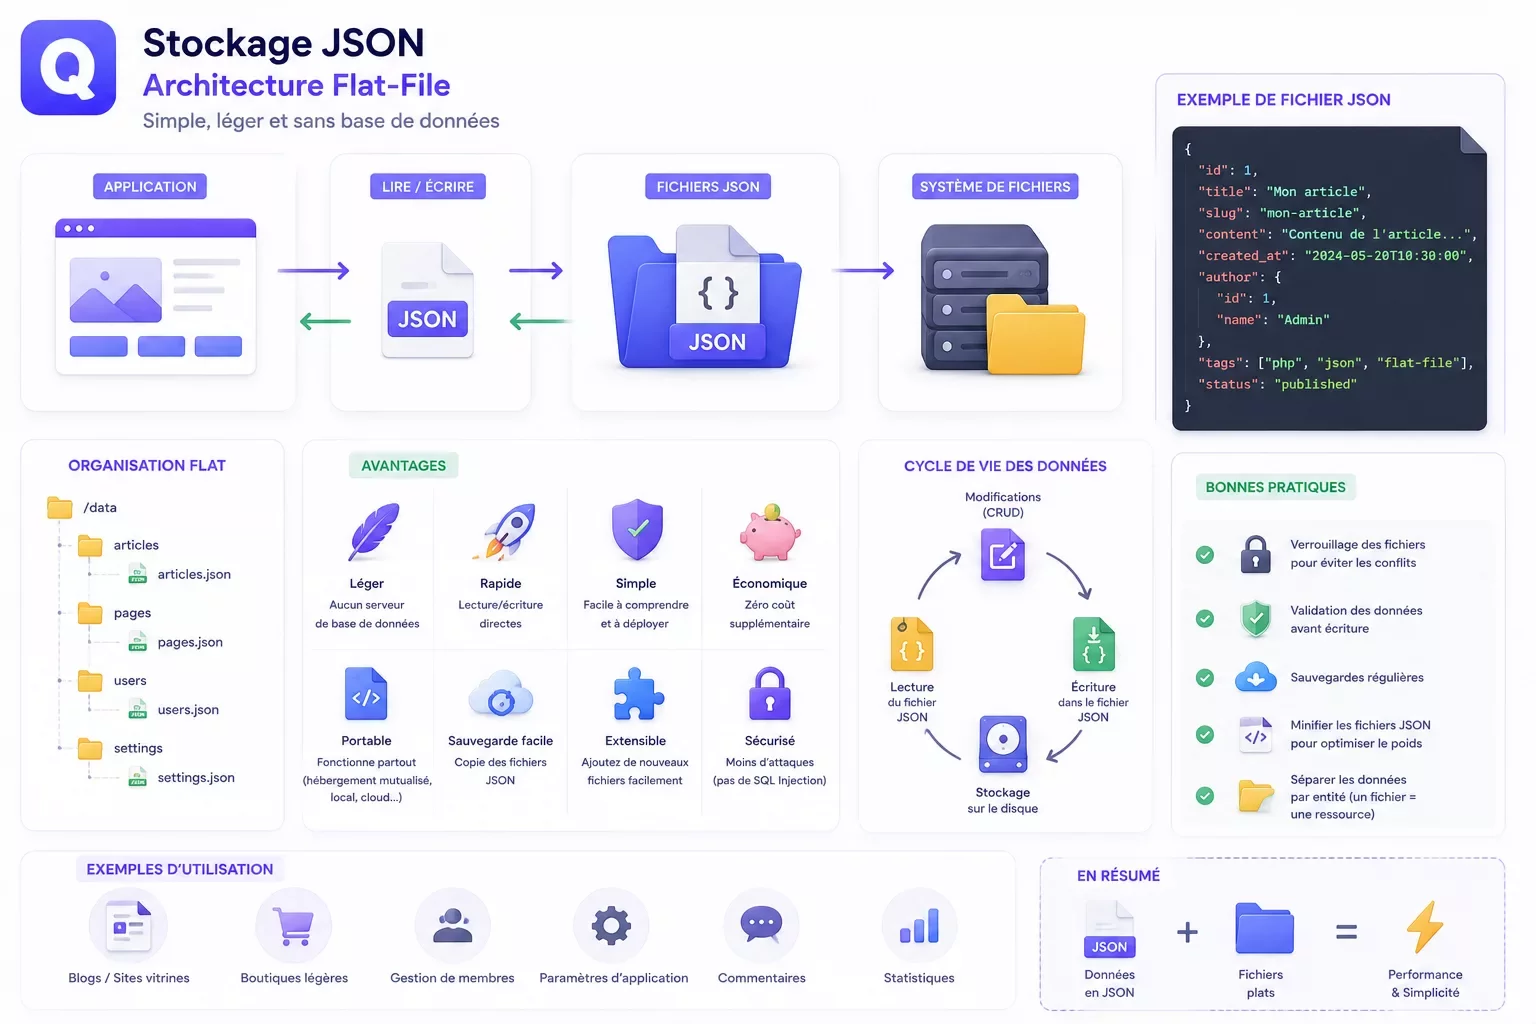
Comment QuietCMS stocke tout le contenu en JSON sans base de données, avec les avantages et les limites du flat-file.
L’architecture de QuietCMS repose sur une séparation simple entre le moteur, les contenus et leur présentation. Le moteur reçoit une requête, identifie la ressource demandée puis transmet ses données au thème actif. Une page, un article ou une catégorie possède ses propres champs dans un fichier JSON. Le thème transforme ces informations en HTML. Cette organisation permet de comprendre où se trouve une donnée avant de chercher comment elle apparaît à l’écran. Une modification de texte relève du contenu ; une modification de mise en page relève du thème ; une règle de routage relève du moteur. Cette distinction évite de disperser les corrections dans plusieurs couches sans savoir laquelle produit réellement le résultat. Le terme anglais flat-file décrit ce stockage dans des fichiers plutôt que dans une base SQL. Il ne signifie pas que le site se limite à des pages statiques ou qu’il ne possède pas d’administration. QuietCMS conserve un back-office complet, des rôles, des formulaires et des extensions. Le choix concerne la manière de conserver les informations, pas la richesse de chaque interface. Pour un développeur, le bénéfice est de pouvoir examiner les données avec des outils courants, suivre leurs changements et préparer une migration sans commencer par extraire une base. Cette lisibilité facilite le diagnostic, à condition de connaître les conventions du CMS et de préserver les protections des dossiers internes. Elle ne dispense ni de sauvegardes ni de contrôles sur les écritures réalisées par plusieurs utilisateurs.
Un fichier de page rassemble notamment son identifiant, son titre, son adresse, ses métadonnées et son corps éditorial. Un article ajoute des informations propres à la publication, comme sa rubrique ou sa date. Le format JSON décrit des valeurs, pas une mise en page complète : le thème garde la responsabilité du rendu. Cette séparation aide à changer un habillage sans ressaisir chaque texte. Elle permet aussi de contrôler les informations qui seront exploitées par les moteurs, les archives et les outils de recherche interne. Le fichier doit rester valide après toute intervention manuelle. Une chaîne non fermée, un caractère mal échappé ou une virgule ajoutée au mauvais endroit suffit à empêcher sa lecture. L’édition passe donc de préférence par l’administration, qui connaît le schéma attendu, ou par un script utilisant les fonctions du moteur. Si un outil externe modifie les données, il faut tester les fichiers produits avant leur transfert. Le corps d’un article peut contenir du HTML tout en restant une chaîne JSON ; les règles de ces deux formats s’appliquent alors simultanément. Les valeurs techniques ne doivent pas être confondues avec leur affichage visible. Le slug d’un contenu, son H1 et sa balise title peuvent répondre à des besoins distincts. Leur cohérence aide à retrouver une ressource, mais les rendre systématiquement identiques n’est pas une obligation du stockage. Lorsqu’une équipe intervient à plusieurs, un exemple documenté et une validation automatique évitent que chacun introduise une variante du format. Le contenu reste ainsi portable sans perdre sa structure ni les réglages qui lui donnent son contexte.
Le point d’entrée du site reçoit le chemin demandé et le transmet au routeur. Celui-ci détermine s’il correspond à une page, une rubrique, un article ou une ressource particulière. Le moteur charge ensuite les données utiles et choisit le modèle adapté. Le fichier de mise en page ajoute les éléments communs, comme l’en-tête, la navigation, les métadonnées et le pied de page. Le modèle de contenu produit la partie spécifique de la réponse. Cette succession explique pourquoi une même correction ne s’applique pas toujours dans le même fichier. Une erreur de titre visible peut venir du contenu ; une mauvaise URL canonique peut venir d’un réglage ou du calcul effectué avant le rendu. La méthode consiste à suivre le trajet réel de la requête plutôt qu’à modifier directement le dernier fichier aperçu. Les fonctions natives construisent les chemins des pages et des articles en tenant compte de leur organisation. Les utiliser évite de reproduire des règles de liens à plusieurs endroits du thème. Cette précaution devient importante lorsqu’un site change la structure de son blog ou active plusieurs langues. Une URL fabriquée à la main peut continuer à sembler correcte tout en menant vers une ancienne adresse. Les redirections permettent d’accompagner une évolution, mais elles ne doivent pas remplacer une génération propre des liens. Un changement de routage se vérifie sur la page d’accueil, une page profonde, une archive, un article et une adresse inconnue. Ce petit ensemble couvre des chemins différents et révèle plus vite une régression qu’un contrôle limité à la racine.
Le cache de pages conserve une réponse déjà produite pour éviter de reconstruire inutilement la même page à chaque visite. Cette économie concerne le travail du serveur ; elle ne compresse pas à elle seule les images ni les scripts du navigateur. Elle fonctionne bien lorsque les règles d’éligibilité sont explicites. Une page dépendant d’une session, d’une recherche ou d’un formulaire ne se traite pas comme une simple page de contenu identique pour tous. Le moteur doit distinguer ces situations afin de ne pas présenter à un visiteur des informations appartenant à un autre contexte. Lors d’une modification, la question centrale est l’invalidation : quand la réponse enregistrée cesse-t-elle de représenter le contenu courant ? QuietCMS possède ses mécanismes de cache et de purge. Une intervention directe sur les fichiers peut toutefois contourner les opérations normales du back-office. Après un transfert de thème ou de contenu, il faut donc appliquer la procédure prévue par le projet. Réimporter un ancien dossier de cache est une source classique de confusion : la nouvelle version existe sur disque, mais le public continue de recevoir un ancien rendu. Pour diagnostiquer, comparer une réponse servie normalement à une réponse qui contourne le cache permet de séparer un défaut de code d’une copie périmée. La validation se poursuit ensuite après purge, sans conserver le paramètre de diagnostic dans les liens publics. Un cache utile reste invisible pour le visiteur ; un cache mal invalidé rend les mises à jour imprévisibles.
Un déploiement doit distinguer ce qui appartient au logiciel de ce qui appartient au site. Le moteur et certaines extensions peuvent venir d’une version de référence. Les contenus, les réglages, les médias et les choix de thème sont propres au projet. Copier indistinctement tout un dossier d’installation risque d’écraser des données qui n’ont rien à voir avec la mise à jour recherchée. La préparation commence par un inventaire des fichiers modifiés et par une sauvegarde exploitable. Il faut ensuite comparer les versions, relever les adaptations locales et décider lesquelles doivent être conservées. Les fichiers de configuration peuvent contenir des informations sensibles ; ils ne se partagent pas avec les captures ou les archives destinées à une démonstration. La recette porte sur les parcours réels du site : pages, navigation, recherche, formulaires, administration et tâches de publication. Lorsque le transfert se fait par FTP, la cohérence du lot compte autant que son contenu. Mélanger des fichiers provenant de deux versions peut créer un état intermédiaire difficile à diagnostiquer. Préparer un paquet identifié et noter la procédure de retour arrière réduit cette incertitude. Un environnement de prévisualisation permet de vérifier la version sans déclencher les notifications du site public ni utiliser ses identifiants. La légèreté du stockage simplifie la copie des contenus, mais elle ne remplace pas cette discipline. Un site facile à déplacer doit également rester facile à remettre dans un état connu après un incident ou une livraison interrompue.
Le thème décrit la présentation et le parcours éditorial ; l’extension ajoute un comportement réutilisable ou une intégration. Cette distinction sert de règle de décision lorsqu’une demande arrive. Modifier les espacements d’une page relève du thème. Ajouter un connecteur ou une opération métier partagée relève plus souvent d’une extension. Le moteur conserve les fonctions communes dont l’ensemble du site dépend. Répartir les responsabilités de cette manière limite les corrections à recopier lors des mises à jour. Une personnalisation peut rester petite tout en étant bien isolée. Le critère n’est pas le nombre de fichiers, mais la clarté du contrat entre les données reçues et le résultat attendu. Les points d’extension du CMS doivent être utilisés lorsqu’ils répondent au besoin. Modifier le noyau reste parfois nécessaire, mais cette décision doit être identifiée et documentée, afin de ne pas disparaître au prochain remplacement du moteur. Un thème peut exploiter une fonctionnalité d’extension sans supposer qu’elle sera toujours active. Prévoir un repli raisonnable évite de rendre toute une page dépendante d’un module secondaire. Cette prudence vaut aussi pour les outils IA : leur indisponibilité ne doit pas empêcher l’affichage des contenus déjà publiés. Une architecture maintenable permet de comprendre une dépendance et de la retirer sans reconstruire le site. Elle rend les développements successifs plus lisibles pour la personne qui reprendra le projet, qu’il s’agisse de son auteur initial ou d’un autre membre de l’équipe.
La performance observée résulte du serveur, du thème, des ressources et du contexte de visite. Un stockage léger peut réduire certaines opérations sans empêcher une photographie trop lourde de ralentir l’affichage. À l’inverse, un beau score obtenu sur une page simple ne prouve pas que toutes les pages du site se comporteront de la même façon. La mesure commence par des scénarios représentatifs : accueil, article long, archive illustrée et formulaire. Il faut relever les conditions de test et comparer des situations comparables. Un environnement local ne reproduit pas nécessairement le réseau, le cache ou les ressources du serveur public. Les mesures doivent être interprétées avec leurs limites, pas transformées en promesse absolue. Pour corriger, on cherche d’abord le facteur qui pèse réellement : réponse serveur, image principale, polices, scripts tiers ou décalages de mise en page. L’architecture du CMS constitue une partie de ce travail. Le thème doit réserver les dimensions des images, différer les ressources qui peuvent attendre et conserver une hiérarchie de chargement cohérente. Une intervention utile modifie un goulot identifié, puis vérifie que le parcours reste fonctionnel. Ajouter une bibliothèque pour résoudre un détail visuel peut annuler une économie obtenue ailleurs. Une approche sobre privilégie donc les fonctions natives du navigateur quand elles suffisent. Le résultat recherché est un site utilisable, stable et compréhensible, pas une démonstration technique qui ne tient que dans une configuration de test.
Une reprise commence par les données et les adresses, avant de se concentrer sur le dessin des pages. Il faut inventorier les types de contenus, les médias, les champs SEO, les auteurs et les liens existants. L’objectif est de savoir ce qui doit rester identique, ce qui sera transformé et ce qui ne sera pas repris. Cette cartographie évite de découvrir après livraison qu’une fonction éditoriale reposait sur un champ non exporté. Le passage vers des fichiers JSON ne se résume pas à copier du texte : les identifiants, les relations de rubrique et les règles de publication doivent rester cohérents. Un premier lot de test révèle les différences de format avant le traitement complet. Les URL importantes méritent un contrôle particulier, car elles portent des liens entrants et des habitudes de consultation. Lorsque leur structure change, les redirections se préparent avec les nouvelles destinations réellement accessibles. La recette inclut les métadonnées, les images, les caractères accentués, la pagination et les formulaires. Pour la suite, une documentation courte précise l’emplacement des fichiers, les personnalisations et les opérations de sauvegarde. Le livrable devient alors un système que l’équipe sait maintenir, pas seulement une interface validée le jour du lancement. L’architecture reste au service de cette transmission : rendre les choix visibles, limiter les surprises et donner au prochain développeur les moyens de comprendre ce qui a été construit.
Un exercice de reprise peut partir d’une copie isolée du site et d’une modification très limitée.