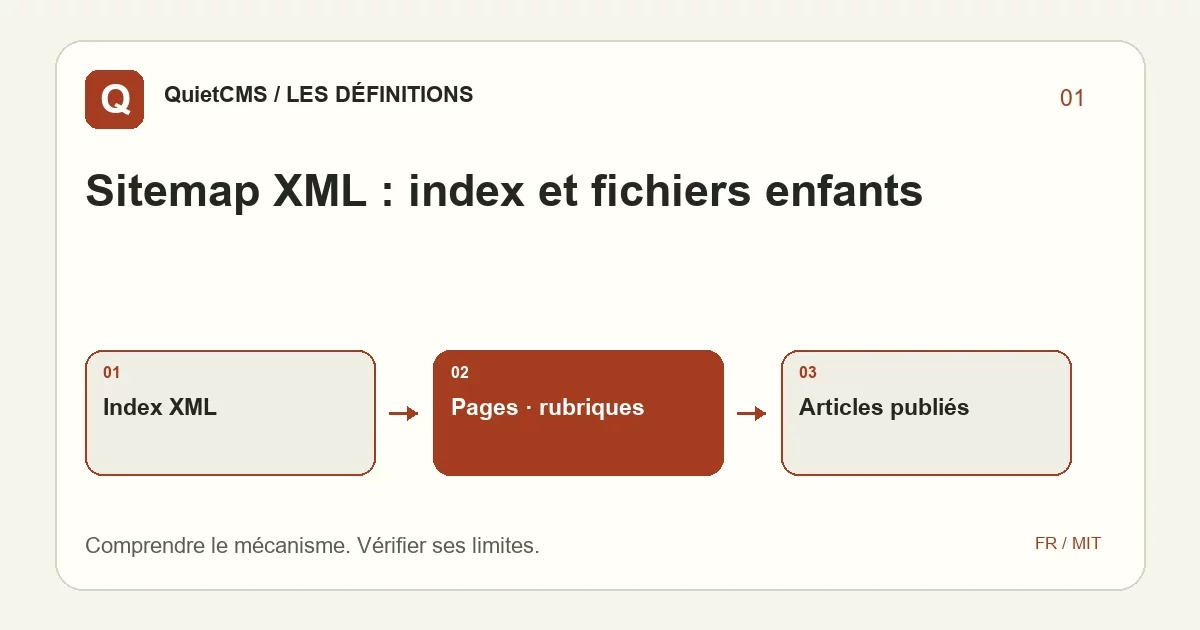
Un sitemap XML présente des URL à des outils qui explorent un site. Lorsqu’il existe plusieurs fichiers de ce type, un index peut les regrouper en indiquant leurs adresses. QuietCMS utilise cette organisation pour séparer notamment les pages, les catégories et les articles. Elle permet de rendre le périmètre publié plus lisible, sans demander à l’équipe de maintenir manuellement une liste indépendante pour chaque mise à jour. Le mécanisme reste une aide à la découverte, pas une promesse de classement ni une obligation d’indexation imposée à un moteur. Comprendre l’index et ses fichiers enfants aide à vérifier une publication, à repérer une URL absente et à distinguer un problème de génération d’un problème d’accès public au document produit par le CMS.
Repère QuietCMS. Le moteur produit un index
sitemap.xmlet des fichierssitemap-pages.xml,sitemap-categories.xmletsitemap-posts.xml. Il faut contrôler l’index et les enfants, pas seulement compter les lignes du premier fichier.
Quelle différence existe entre un sitemap et son index ?
Un fichier de sitemap contient des adresses de ressources à explorer selon le format prévu. Un index de sitemaps contient des adresses de fichiers de sitemap. Cette différence est essentielle lorsque l’on examine le document servi à la racine. Voir une liste relativement courte dans sitemap.xml ne signifie pas que les articles ont disparu : le document peut simplement pointer vers des fichiers spécialisés qui les regroupent. La vérification doit donc suivre ces références et lire le bon niveau. Un outil qui attend directement toutes les pages dans l’index risque de produire un faux diagnostic. Le développeur doit d’abord identifier la structure servie, puis comparer les groupes et les URL attendus au contenu réel de chaque fichier concerné.
Dans QuietCMS, cette séparation suit les familles de contenus. Les pages, les catégories et les articles peuvent apparaître dans des fichiers distincts. Le moteur applique les règles de visibilité avant de les lister. Le lecteur humain conserve une navigation éditoriale différente : un menu ou un plan de site HTML n’a pas exactement le même rôle. Le sitemap XML n’est pas destiné à remplacer les liens qui permettent de comprendre les relations entre les sujets. Il fournit une représentation technique d’adresses, tandis que l’architecture éditoriale organise un parcours. Les deux doivent rester cohérents sans être confondus. Un site peut posséder un sitemap complet et proposer malgré tout un maillage peu utile aux personnes qui découvrent ses contenus.
Les adresses doivent être cohérentes avec le domaine et les routes du site. Une référence vers un environnement local ou un ancien nom ne devient pas correcte parce qu’elle est placée dans un document XML valide. Le contrôle doit donc examiner les valeurs, pas seulement la syntaxe. Après une migration, une restauration ou un changement de structure, les fichiers générés doivent refléter l’environnement réellement public. Cette attention concerne aussi les URL d’articles construites à partir des réglages du CMS. Un outil de génération doit utiliser les conventions du moteur, notamment lorsque les catégories ou le multilingue influencent les chemins. Une liste obtenue par concaténation approximative peut sembler plausible et pourtant envoyer les outils d’exploration vers des destinations incorrectes.
Les informations complémentaires doivent être interprétées avec mesure. Une date de modification peut aider lorsqu’elle correspond à une modification réelle et reste fiable. D’autres indications prévues dans le protocole ne sont pas nécessairement utilisées par chaque moteur. Il serait donc trompeur de présenter une valeur de priorité comme un réglage direct du classement dans Google. La génération native permet de produire un document structuré, mais le responsable du site doit conserver une lecture réaliste de son influence. Le sitemap signale des ressources et leur contexte ; il ne décide pas seul de leur intérêt, de leur exploration ni de la place qui leur sera accordée dans les résultats d’un service externe. La rubrique sur le référencement de QuietCMS permet de replacer le sitemap parmi les autres réglages, afin que l’équipe ne lui attribue pas un rôle de confidentialité ou d’autorisation qu’il ne remplit pas.
Quels contenus QuietCMS doit-il inclure ou exclure ?
La visibilité éditoriale constitue le premier critère. Les contenus en préparation ne doivent pas être présentés comme des pages publiées uniquement parce que leurs fichiers existent. Les articles planifiés deviennent éligibles au moment de leur publication effective, selon le traitement du moteur. Cette distinction protège le calendrier et évite de dévoiler des ressources qui ne sont pas encore ouvertes à la lecture publique. Le développeur qui contrôle un sitemap doit comparer son contenu aux états attendus, pas à une liste brute de tous les fichiers du dossier. Une différence peut être volontaire et correcte. Le diagnostic commence donc par une définition du périmètre publié et des règles qui doivent s’appliquer à chaque famille de contenus.
Les directives d’indexation demandent également de la cohérence. Un contenu marqué noindex ne doit pas être traité comme une page que le sitemap invite à indexer. QuietCMS applique des exclusions liées à ces réglages. Il faut néanmoins distinguer ce mécanisme d’une protection d’accès. Retirer une URL d’un sitemap ne rend pas une ressource privée, et l’y inclure ne la rend pas automatiquement accessible si le serveur la bloque. Ces fonctions se situent à des niveaux différents.
Les catégories peuvent être examinées comme des ressources éditoriales à part entière, avec leurs propres contenus et relations. Leur présence doit correspondre à une page réellement utile et disponible selon la structure choisie. Il faut vérifier les intitulés, les chemins et les règles applicables, particulièrement lorsqu’une organisation de blog évolue. Une catégorie renommée visuellement ne demande pas nécessairement une modification d’URL, tandis qu’un déplacement peut nécessiter une reprise plus large. Le sitemap doit suivre le résultat final. Cette vérification complète celle des articles : une série correctement publiée peut rester mal organisée si les archives qui la regroupent ne répondent plus aux adresses attendues ou si elles ne présentent pas les contenus dans le contexte prévu.
Les médias et les alternances linguistiques peuvent ajouter d’autres informations au document, selon les options et les fonctions actives. Leur présence demande des données cohérentes. Une image déclarée doit être disponible et correspondre au contenu concerné. Une relation entre langues ne doit pas être inventée à partir de deux pages simplement proches par le sujet. Le moteur utilise les mécanismes prévus par ses extensions, et la personnalisation doit préserver ces conventions. Une validation de syntaxe ne suffit pas à confirmer la justesse de toutes les relations. Le contrôle peut choisir quelques contenus représentatifs et vérifier les adresses associées. Il relie ainsi les possibilités du générateur aux ressources réelles, au lieu de supposer que toute balise supplémentaire constitue automatiquement un bénéfice.
Quand les fichiers sont-ils reconstruits et que change un transfert FTP ?
Le moteur prévoit une reconstruction lors d’opérations qui modifient les contenus ou les réglages concernés. Cette intégration évite de demander une maintenance manuelle de chaque URL après une publication ordinaire dans l’administration. Les articles planifiés participent au même besoin : leur passage à l’état publié doit se refléter dans les documents générés. Le responsable du site doit cependant distinguer les événements applicatifs et les copies directes de fichiers. Un dépôt FTP ne reproduit pas nécessairement toutes les actions d’un enregistrement. Même lorsque le moteur possède des mécanismes de rafraîchissement, une vérification explicite après un transfert important permet de confirmer immédiatement la cohérence attendue, plutôt que de supposer qu’elle sera rétablie à un moment indéterminé.
La reconstruction peut aussi mettre à jour llms.txt lorsque ce dernier est en mode automatique. Cette relation est utile pour maintenir plusieurs représentations du site à partir du même état éditorial. Elle ne signifie pas que les deux formats ont le même contenu ou le même usage. Le sitemap liste des URL selon un protocole XML, tandis que llms.txt présente une organisation textuelle avec des liens et des descriptions. Il faut donc contrôler les deux en fonction de leurs règles. Une absence dans l’un peut provenir d’un réglage spécifique. Le développeur doit examiner le mode et les exclusions avant de conclure à une défaillance générale. Une configuration explicite facilite cette lecture et évite les comportements hérités d’un ancien fichier manuel.
Les conditions d’écriture restent importantes. Un générateur correct peut échouer si le serveur ne peut pas créer ou remplacer les fichiers attendus. Le quota de stockage, les permissions et les erreurs de traitement doivent être examinés lorsque le document reste ancien ou absent. Le diagnostic commence par distinguer l’appel au générateur du résultat réellement produit. Il faut ensuite vérifier que ce résultat est disponible à l’adresse publique attendue, avec un type de réponse cohérent. Un fichier présent dans une copie locale ne prouve pas qu’il existe sur le serveur distant. Cette distinction explique pourquoi un lot de déploiement doit préciser ce qu’il contient et quelles opérations de régénération restent nécessaires dans l’environnement final.
Une procédure de contrôle peut partir d’un contenu témoin. Après publication, on vérifie son adresse dans le groupe approprié, puis la disponibilité du fichier enfant depuis l’index. Après retrait ou modification, on examine l’effet correspondant. La vérification ne doit pas être réduite à une simple recherche de mot dans un fichier : une URL ancienne peut partager une partie de texte avec la bonne destination. Il faut comparer les adresses et les états. Cette méthode apporte une preuve concrète du fonctionnement attendu, sans transformer chaque publication en opération manuelle complexe.
Comment utiliser les sitemaps dans le suivi du référencement ?
Le sitemap peut être communiqué aux outils qui permettent son suivi, mais sa soumission ne constitue pas une demande de classement prioritaire. Un moteur reste responsable de ses décisions d’exploration et d’indexation. Le responsable du site doit donc distinguer la disponibilité du document, sa lecture par un service et le devenir des pages qu’il contient. Ces étapes peuvent évoluer à des rythmes différents. Une correction technique locale n’apparaît pas nécessairement immédiatement dans un rapport externe. Le compte rendu doit conserver cette différence de temporalité. Il peut confirmer que le sitemap public est cohérent sans affirmer que toutes les pages ont déjà été revisitées ou retenues par un moteur au moment du contrôle.
La comparaison avec les autres signaux du site reste utile. Les liens internes, les URL canoniques, les redirections et les directives d’indexation doivent raconter une organisation compatible. Une page listée dans le sitemap mais redirigée vers une autre destination demande une explication. Une archive utile ne devrait pas être rendue introuvable par une ancienne règle de serveur. Le sitemap devient alors un point d’entrée pour repérer les incohérences, pas une solution qui les efface. Le développeur examine un ensemble de relations et corrige la source du décalage. Cette démarche évite de multiplier les fichiers techniques en supposant que leur seule présence compense une architecture éditoriale ou un routage qui ne correspond plus au projet. Le guide sur le protocole Sitemap XML fournit un complément sur la structure.
Les rapports doivent être lus avec les dates et les contextes disponibles. Un outil externe peut encore afficher une observation ancienne après une correction, jusqu’à une nouvelle exploration ou mise à jour de son traitement. Inversement, une réponse correcte à un instant ne garantit pas qu’un problème de quota ou de déploiement ne réapparaîtra pas. L’équipe conserve donc des contrôles proportionnés au rythme de publication et aux changements importants. Elle ne cherche pas à vérifier chaque ligne manuellement tous les jours, mais à disposer de points de contrôle et d’une manière de diagnostiquer un écart. Les fichiers spécialisés facilitent ce travail en permettant de situer rapidement la famille de contenus concernée.
La qualité éditoriale reste enfin indépendante de la simple présence dans un index technique. Un article complet, utile et relié à des ressources pertinentes a besoin d’un accès correct, mais le sitemap ne rédige pas ses explications ni ne vérifie ses affirmations. Le responsable du projet doit maintenir cette séparation entre distribution et contenu. QuietCMS fournit un générateur pour réduire une partie du travail répétitif ; l’équipe conserve les décisions sur ce qui mérite d’être publié et sur la cohérence des parcours. Un suivi bien organisé permet de savoir quelles ressources sont annoncées, à quelles adresses et dans quel état, sans présenter cette annonce comme une garantie de visibilité que ni le format ni le CMS ne peuvent imposer à un moteur externe.
Une vérification XML peut aussi détecter une structure mal formée avant publication. Elle doit être complétée par le contrôle des références entre l’index et les fichiers enfants, car un document syntaxiquement valide peut toujours pointer vers un fichier absent.
Articles similaires
Schema.org : comprendre les données structurées
Schema.org : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites e…
Search Console : vérifier et observer son site
Comprenez search console dans QuietCMS : fonctionnement, usages et limites. Un guide pour préparer l’intégration et véri…
Llms.txt : une génération automatique dans QuietCMS
Llms.txt : définition, mécanismes et usages dans QuietCMS. Une méthode pour comprendre les mécanismes, leurs limites et…